
Um assistente que atende os seus visitantes a qualquer hora.
Ele conversa com quem visita o seu site, responde com base nas informações que você forneceu e mostra à sua equipe o que as pessoas querem. Você decide o que ele sabe, quanto pode gastar e o que pode consultar.
Um atendente que não tira férias, e segue as suas regras.
Responde a qualquer hora
Dúvidas sobre os seus serviços, preços, horários ou o seu trabalho, respondidas na hora, inclusive à noite e nos fins de semana.
Usa as suas informações
Ele segue os textos que você escreveu e consulta os seus outros documentos quando a pergunta pede.
Respeita o seu orçamento
Limites diários de uso que você define: o gasto com a IA nunca passa do teto.
Conta o que as pessoas querem
Resumos anônimos das conversas, quando o visitante escolhe enviar para a sua equipe.
É honesto com o visitante
Diz que é uma IA, não finge ser uma pessoa e não revela as instruções internas.
Consulta dados atualizados
Se você permitir, ele consulta uma lista de preços ou outra página sua para responder com a informação do dia.
Você ensina o assistente com textos simples.
Tudo o que ele sabe vem de documentos que você escreve, como se estivesse orientando um novo atendente: quem você é, o que oferece, preços, horários, perguntas frequentes e o jeito de falar.
- Escreva você mesmo, ou conte numa conversa e, na implementação, os textos são escritos para você.
- Mudou um preço? Atualize o texto, e o assistente passa a responder com a informação nova.
- Documentos longos, como uma tabela de preços ou uma política de trocas, ele só consulta quando a pergunta pede.
- Os textos ficam guardados no GitHub, com o histórico de cada alteração.
Assistente da Exemplo Consultoria
Você atende os visitantes do site da Exemplo Consultoria, em São Paulo.
- Responda em português, de forma cordial e objetiva.
- Atendemos de segunda a sexta, das 9h às 18h.
- Para falar de preços, consulte o documento precos.
- Para marcar uma reunião, indique o formulário de contato.
- Não prometa prazos: diga que a equipe confirma por e-mail.
Você decide quanto ele pode gastar.
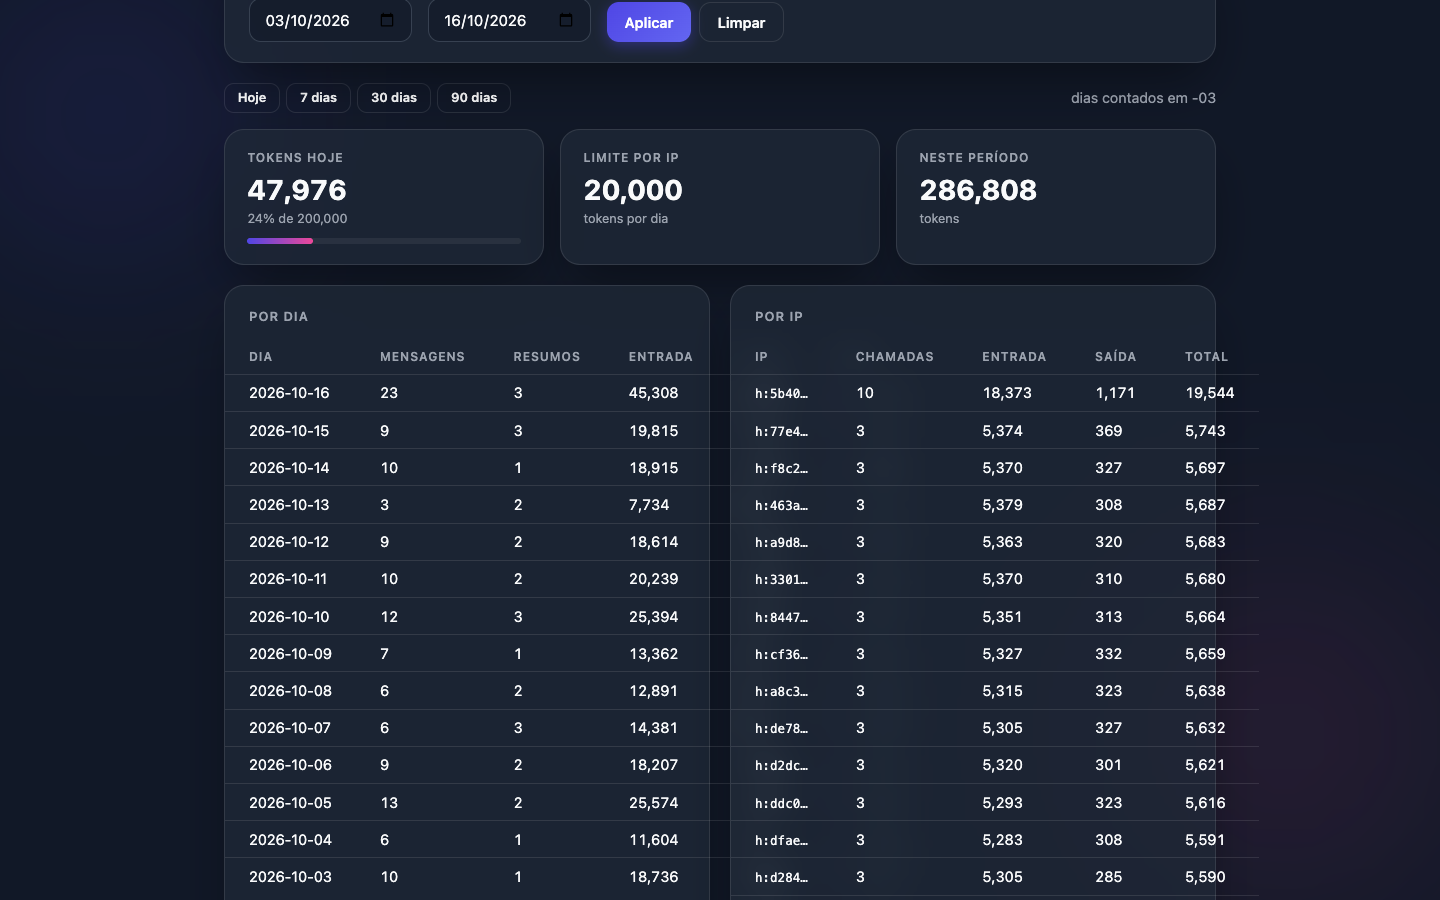
Os provedores de IA cobram pelo volume de texto que a IA lê e escreve, medido em “tokens” (pedaços de palavras). O Emissario confere os limites antes de cada resposta, então um dia movimentado nunca passa do teto que você definiu.
- Quando um limite é atingido, o visitante vê um aviso para voltar mais tarde, e o chat volta à meia-noite.
- O painel mostra o uso de cada dia, comparado ao limite, e quem chegou ao seu limite.
Saiba o que os visitantes perguntam, sem saber quem eles são.
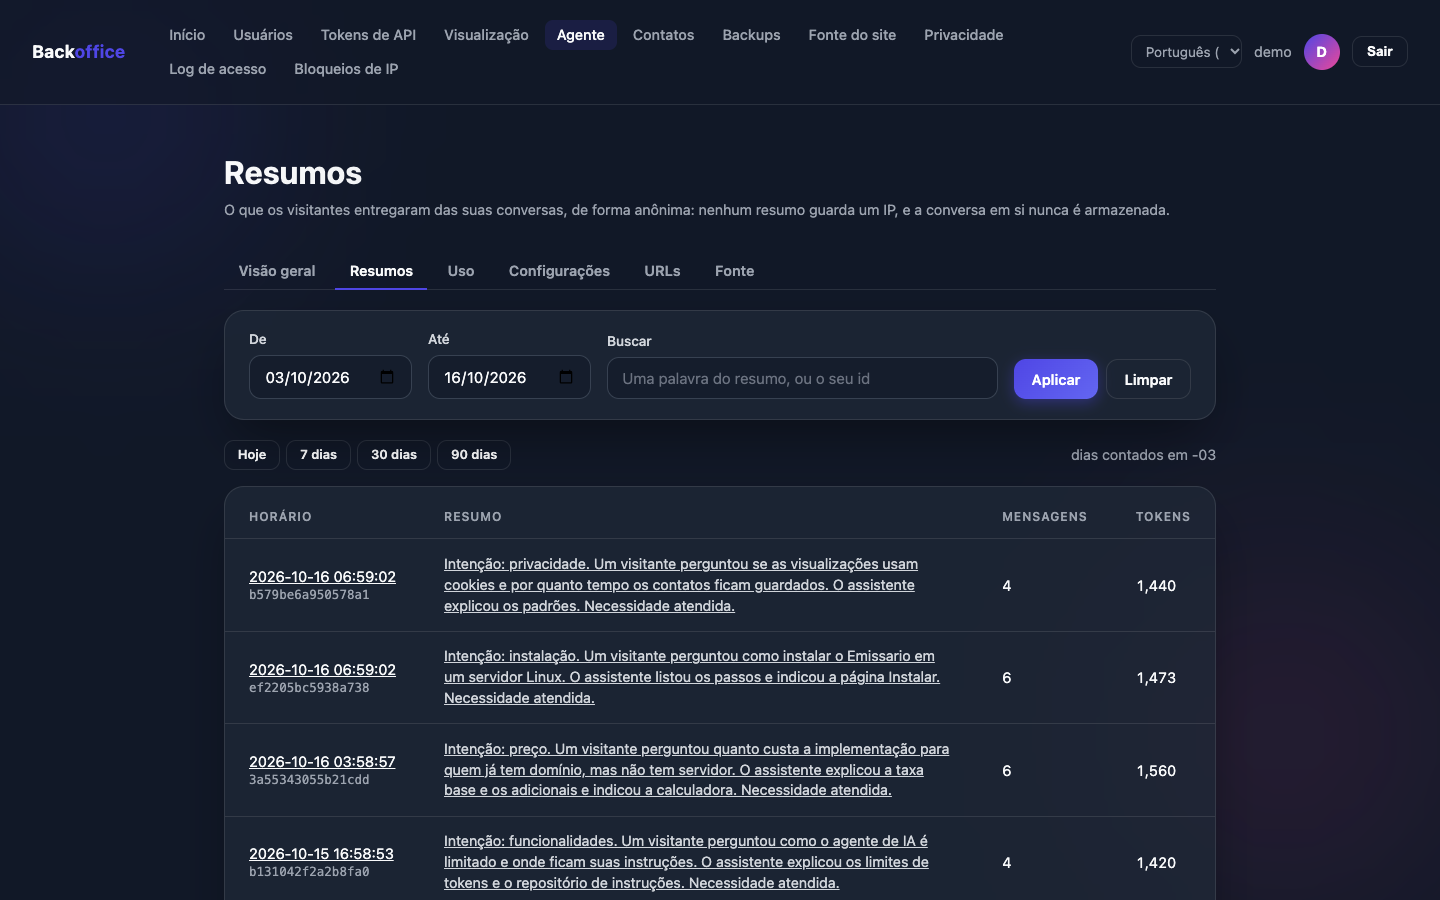
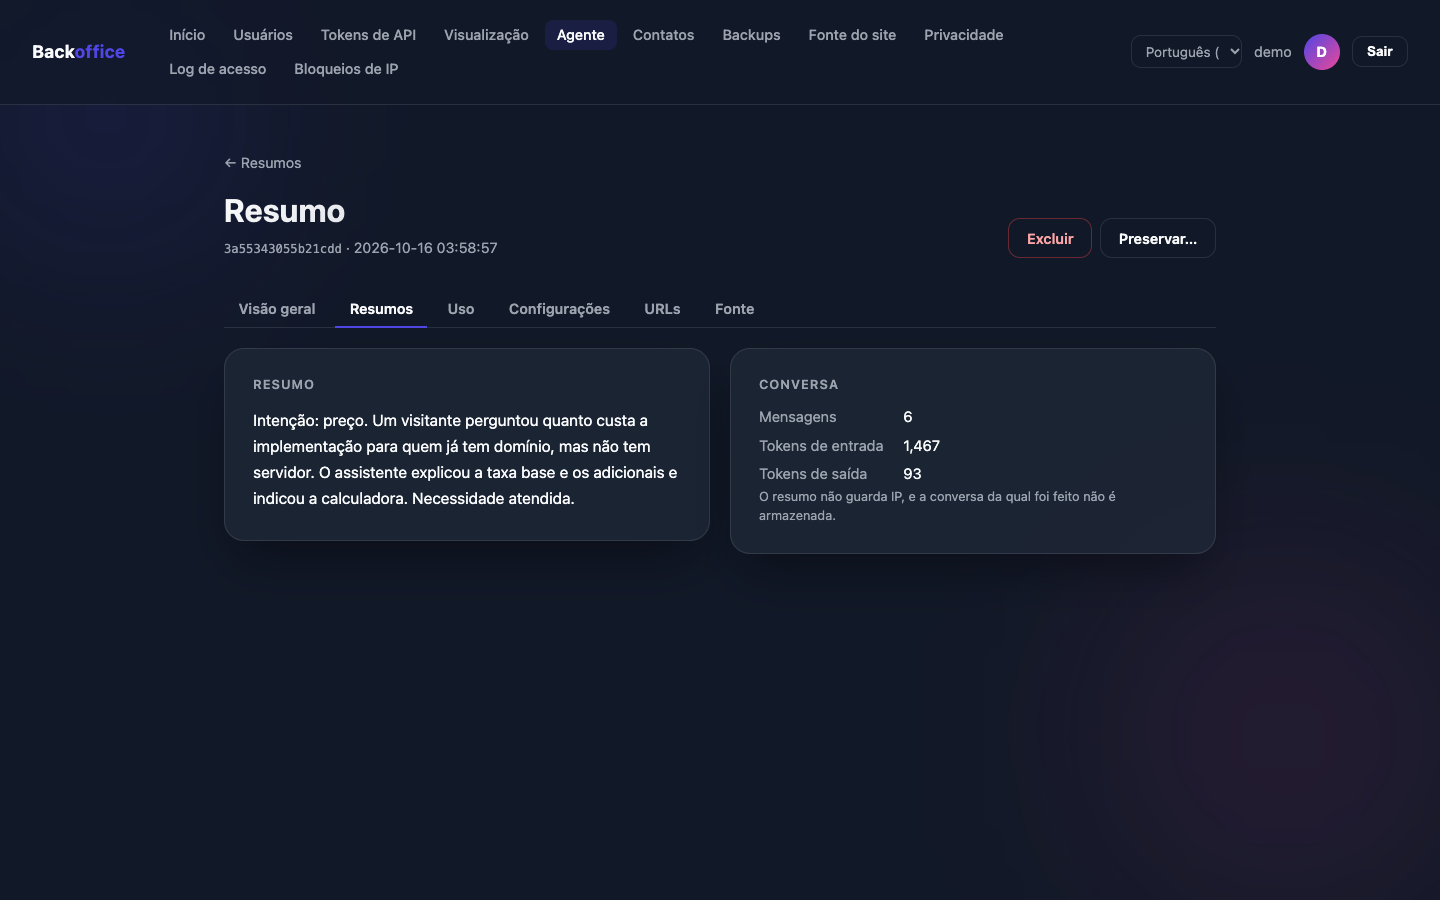
Ao final de uma conversa, o visitante pode enviar um resumo para a sua equipe. É assim que você descobre as dúvidas mais comuns, os pedidos de orçamento e o que está faltando no seu site.
- 01
O visitante escolhe enviar
Um botão no chat, depois de uma resposta. Nada é enviado sem ele pedir.
- 02
A IA escreve um resumo
Sem nomes, datas, lugares, documentos, telefones, e-mails ou endereços.
- 03
Uma revisão automática limpa o resto
O que ainda parecer CPF, CNPJ, e-mail, telefone ou cartão é trocado por uma etiqueta.
- 04
A sua equipe lê no painel
Guardado de forma criptografada, sem o endereço de internet do visitante, por 90 dias por padrão.
Intenção: preço. Um visitante pediu um orçamento e pediu para ser contatado em ana@example.com [email] ou +55 11 90000-0000 [phone].
- Busque os resumos por período ou por palavra.
- Os resumos ficam desligados até você ligar, depois de um aviso sobre os dados pessoais que podem conter.
- Uma IA pode errar, então o resumo é protegido como dado pessoal e pode ser apagado a pedido.
- O chat deste site tem o botão Enviar um resumo para a equipe: experimente.
Honesto com os visitantes, por padrão.
Ele diz que é uma IA
Na primeira resposta e sempre que perguntado, e nunca se passa por uma pessoa. O chat também avisa antes da primeira mensagem, como pede o AI Act europeu.
A conversa fica com o visitante
Ela é guardada no navegador do visitante, não no servidor, com uma assinatura digital: ninguém consegue forjar uma resposta do assistente.
Ele guarda os seus segredos
Nunca revela as instruções internas, senhas ou endereços de sistemas, e não obedece a ordens escondidas nos documentos que consulta.
O que o provedor de IA recebe
O provedor de IA é outra empresa, que recebe a conversa para gerar cada resposta. Vale assinar com ele um contrato de tratamento de dados, ou usar um modelo no seu próprio servidor, com o Ollama, para que as conversas não saiam da sua estrutura.
| Enviado | A cada mensagem |
|---|---|
| A conversa | Cada mensagem do visitante e do assistente, como foi digitada. |
| As instruções | As regras do Emissario e as suas instruções. |
| O que ele consultou | Os documentos que leu e o que as páginas consultadas responderam. |
| Um pedido de resumo | A conversa inteira de novo, só quando o visitante pede. |
Escolha a IA que preferir.
O assistente funciona com vários provedores de IA. Você usa a sua própria conta e paga direto a eles, ou roda um modelo no seu servidor.
- OpenAI
- OpenRouter
- Groq
- Ollama (no seu servidor)
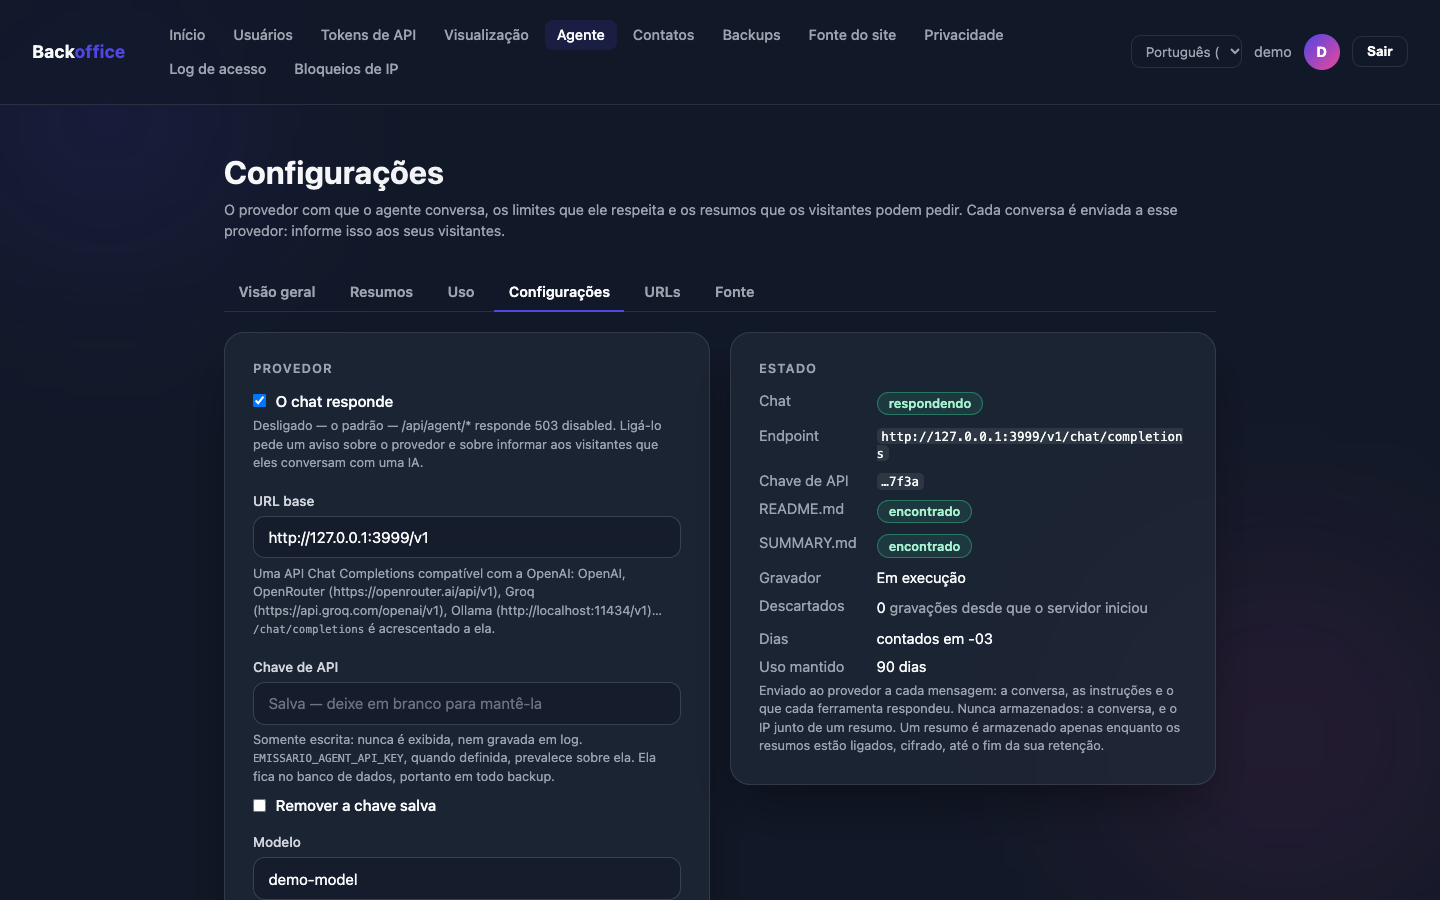
- A chave de acesso à sua conta no provedor fica escondida: o painel mostra no máximo os quatro últimos caracteres.
- Com o Ollama, as conversas não saem da sua estrutura e não há custo por mensagem.
Deixe que ele consulte, só onde você permitir.
Você pode autorizar o assistente a consultar endereços específicos, como uma lista de preços ou uma agenda de vagas, para responder com os dados do momento.
- Ele só consulta o que você cadastrou, pelo nome. Nunca um endereço inventado.
- As senhas de acesso a esses endereços ficam escondidas, inclusive do próprio modelo de IA.
Tudo o que o assistente consulta, qualquer visitante pode perguntar a ele. Autorize apenas informações que podem ser públicas.
Detalhes técnicos.
Como o assistente funciona por dentro, para quem vai avaliar ou instalar. A documentação do agente tem tudo.
O caminho de uma mensagem
- O navegador envia a conversa inteira e a assinatura da última resposta para
POST /api/agent/messages. O histórico fica no navegador do visitante. - O Emissario confere a origem, os bloqueios de IP, a assinatura, as requisições por minuto e os tokens restantes do dia, antes de chamar qualquer modelo.
- As regras entram: primeiro as do próprio Emissario, depois o seu
instructions/README.md. Nenhuma mensagem consegue mudá-las. - Ferramentas: o modelo pode listar e ler os arquivos de
instructions/, ou chamar as URLs declaradas, em até 5 rodadas por mensagem. - A resposta volta assinada com HMAC-SHA256. O Emissario registra os tokens usados, nunca a conversa.
O repositório de instruções
- O repositório do agente é sincronizado como o site: em um intervalo, ou pelo botão Sincronizar. Os arquivos são lidos a cada mensagem.
instructions/README.mdguarda as instruções de sistema. Sem ele, o chat responde503 no-instructions.instructions/SUMMARY.md, opcional, acrescenta regras para os resumos, por exemplo classificar a intenção.- O modelo lista e lê os outros arquivos conforme precisa, até 64 KiB cada. Arquivos ocultos ficam de fora.
emissario drop-agents-skillsescreve a skill que o Claude Code, o Codex e o Antigravity carregam para escrever esses arquivos.
my-agent/
└── instructions/
    ├── README.md      # quem é o agente, o que ele responde
    ├── SUMMARY.md     # opcional: regras para os resumos
    ├── pricing.md     # lido quando o visitante pergunta
    └── policies/
        └── refunds.md
Limites e padrões
| Configuração | O que limita |
|---|---|
max-tokens (padrão 1024) | Tokens de saída de cada chamada ao provedor. |
daily-limit | Tokens de entrada e saída do dia, todos os visitantes juntos. |
ip-daily-limit | Os tokens de um IP no dia; um endereço IPv6 conta pelo seu /64. |
rate-per-minute (padrão 10) | Requisições por minuto de um IP. |
- Uma chamada em andamento reserva
max-tokensaté responder, então requisições simultâneas nunca passam de um limite juntas. - Cada rodada de ferramenta e cada resumo contam, entrada e saída.
- Acima de um limite:
429 daily-limitouip-daily-limit, até a meia-noite. - Uma conversa: até 50 mensagens, 4.000 caracteres por mensagem, 64 KiB por requisição, 60 s por resposta com ferramentas.
- O uso é guardado por 90 dias, com o IP em hash por padrão; um viewer vê os IPs mascarados.
Provedores e chave de API
Qualquer modelo compatível com a API da OpenAI que suporte chamada de ferramentas. O Emissario chama <base-url>/chat/completions.
| Provedor | URL base |
|---|---|
| OpenAI | https://api.openai.com/v1 |
| OpenRouter | https://openrouter.ai/api/v1 |
| Groq | https://api.groq.com/openai/v1 |
| Ollama (local) | http://localhost:11434/v1 |
- A chave de API é somente escrita: uma página mostra no máximo os quatro últimos caracteres, nunca para um viewer, nunca em um log.
EMISSARIO_AGENT_API_KEYtem prioridade sobre a chave salva no backoffice.
Resumos
- O chat envia a conversa e a assinatura para
POST /api/agent/summaries; uma conversa que o agente nunca teve é recusada. - A segunda passada troca CPF, CNPJ, e-mail, telefone e cartão por
[cpf],[cnpj],[email],[phone]e[card]. - O visitante recebe uma referência de 16 caracteres. Um root apaga um resumo, ou todos antes de uma data, e pode colocar um em retenção legal.
URLs que o agente pode chamar
- Cada URL tem um nome, uma descrição, GET ou POST, e cabeçalhos que o próprio servidor acrescenta.
- O modelo nunca escreve uma URL: ele chama um endpoint pelo nome.
- Os cabeçalhos são somente escrita: nunca mostrados ao modelo, a um viewer, nem de novo a um root.
- Nenhum redirecionamento é seguido; só texto ou JSON é lido, cortado em 32 KiB, em até 10 segundos.
- name
- implementation-prices
- method
- GET
- url
- https://example.com/prices.json
- description
- Os preços dos planos. Chame antes de falar de preço.
- headers
- Authorization: ••••••••
Converse com ele. Depois, tenha o seu.
O chat deste site roda no Emissario. Pergunte qualquer coisa, e depois veja quanto custa ter um assistente assim no seu site.